给 Qwen 装上一颗 CPU:Qwenputer 如何在模型内部运行 RISC-V
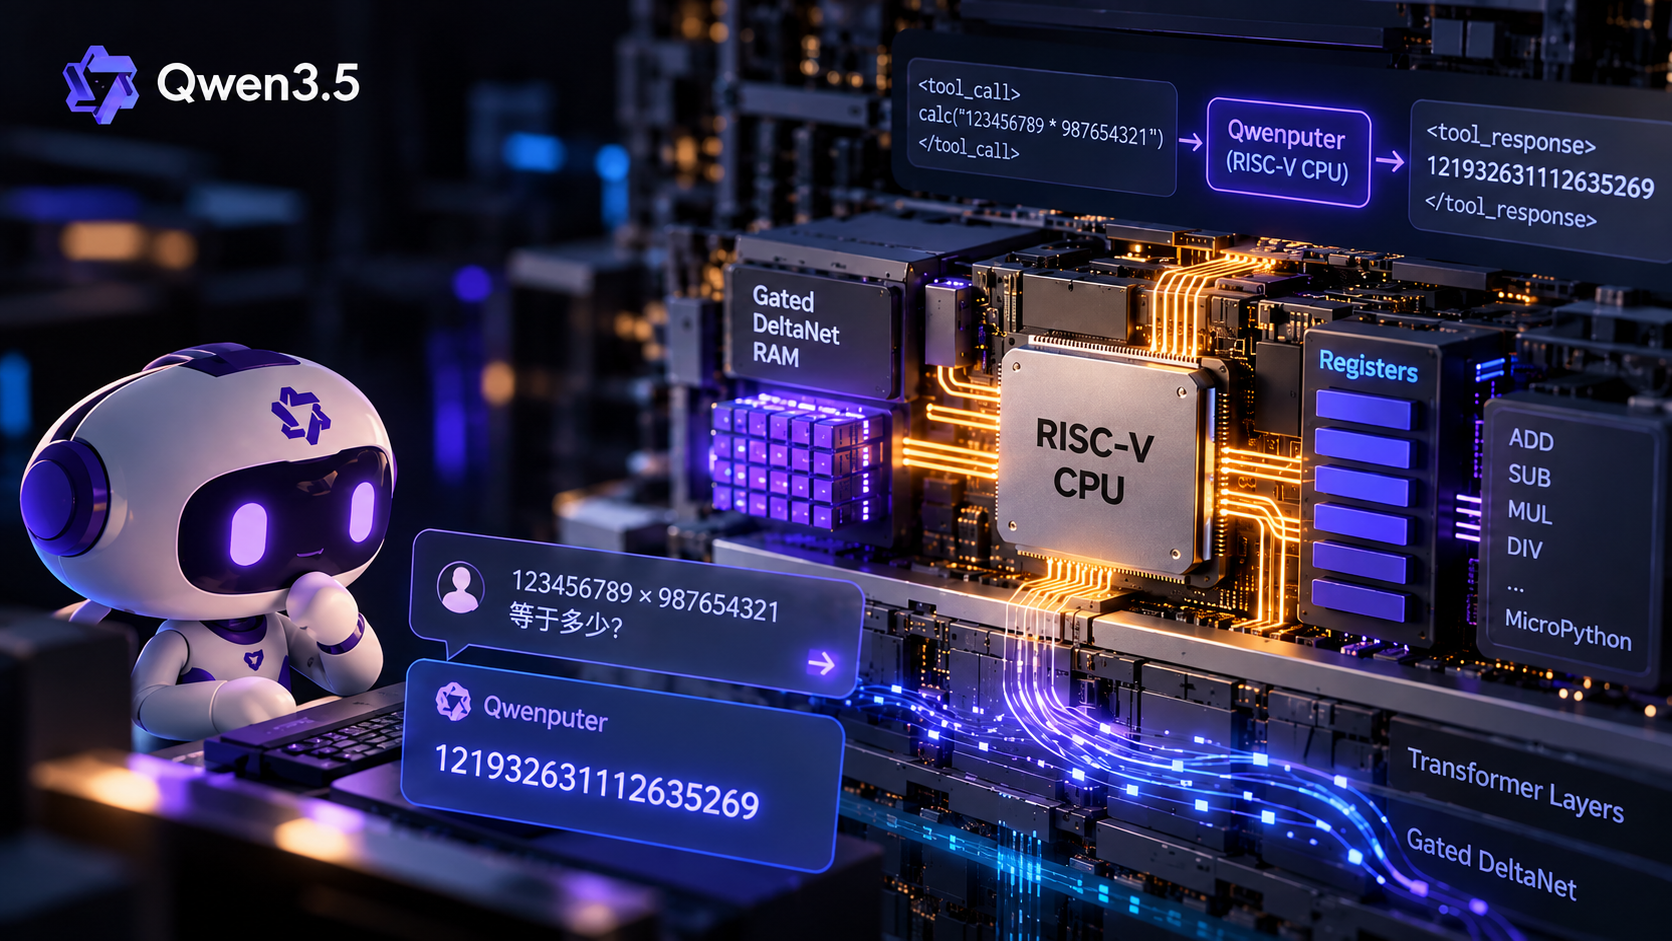
10 月 22 日,一位叫做 Divyansh Agrawal 的研究者发布了一篇很有意思的技术文章:Qwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5。
作者做了一件听起来有些不可思议的事情:在 Qwen3.5-4B 的神经网络内部,嵌入了一颗完整的 32 位 RISC-V CPU。
这颗 CPU 可以执行整数运算和 C 程序,底层计算核心甚至能够运行 MicroPython。它不需要调用外部的 Python 解释器或计算工具;CPU 指令本身由模型的前向传播执行。
更有意思的是,这颗 CPU 完全不需要训练。作者通过编译器直接构造神经网络的权重,把寄存器、算术逻辑单元和指令控制电路编译进了 Transformer。
原来的 Qwen3.5-4B 依然可以正常聊天、回答问题和进行逻辑推理。新增的 CPU 则负责那些需要精确计算的任务。
项目已经开源:
这篇文章最值得关注的有三个地方:如何让 Gated DeltaNet 变成真正可寻址的 RAM,如何把 CPU 电路编译成模型权重,以及如何利用 Token 生成过程驱动 CPU 执行。
一、大模型里面怎么会有 CPU?
首先需要解释一个容易产生误解的概念。
我们平时使用的大模型,本质上仍然是运行在 CPU、GPU 等硬件上的软件。模型中的参数是一组组数字,前向传播则是矩阵乘法、加法和非线性激活等数学运算。
Qwenputer 所谓的「在模型中嵌入 CPU」,并没有在 GPU 内部制造一颗新的物理芯片。
它利用神经网络的数学运算,构造了一套符合 RISC-V 指令语义的计算电路。
其实 CPU 有两个层面的含义。
从硬件层面看,CPU 是由晶体管、逻辑门、寄存器等组成的物理芯片。从计算层面看,CPU 是一套能够读取指令、执行运算、读写内存和控制程序执行流程的系统。
第二个层面完全可以通过软件实现。
例如,我们可以用 Java 写一个非常简单的 CPU 模拟器:
public class VirtualCPU {
    int[] registers = new int[32];
    byte[] memory = new byte[1024];

    void add(int rd, int rs1, int rs2) {
        registers[rd] = registers[rs1] + registers[rs2];
    }
}
如果继续增加指令解码、条件跳转、内存寻址等功能,就可以逐渐实现一套 RISC-V 模拟器。
Qwenputer 的特殊之处在于,它把这些计算逻辑转换成神经网络的运算。
比如 RISC-V 指令:
ADD x3, x1, x2意思是读取 x1 和 x2 寄存器中的值,将两者相加,结果写入 x3。
真实 CPU 通过物理逻辑电路执行这条指令,Java 模拟器通过程序中的整数运算来执行,而 Qwenputer 则通过特殊设计的神经网络层完成读取、加法和写回。
所以,我们可以将 Qwenputer 理解成:在一个负责语言理解和推理的大模型内部,增加了一套由神经网络权重实现的确定性计算系统。
它与传统的大模型工具调用有着明显的区别。
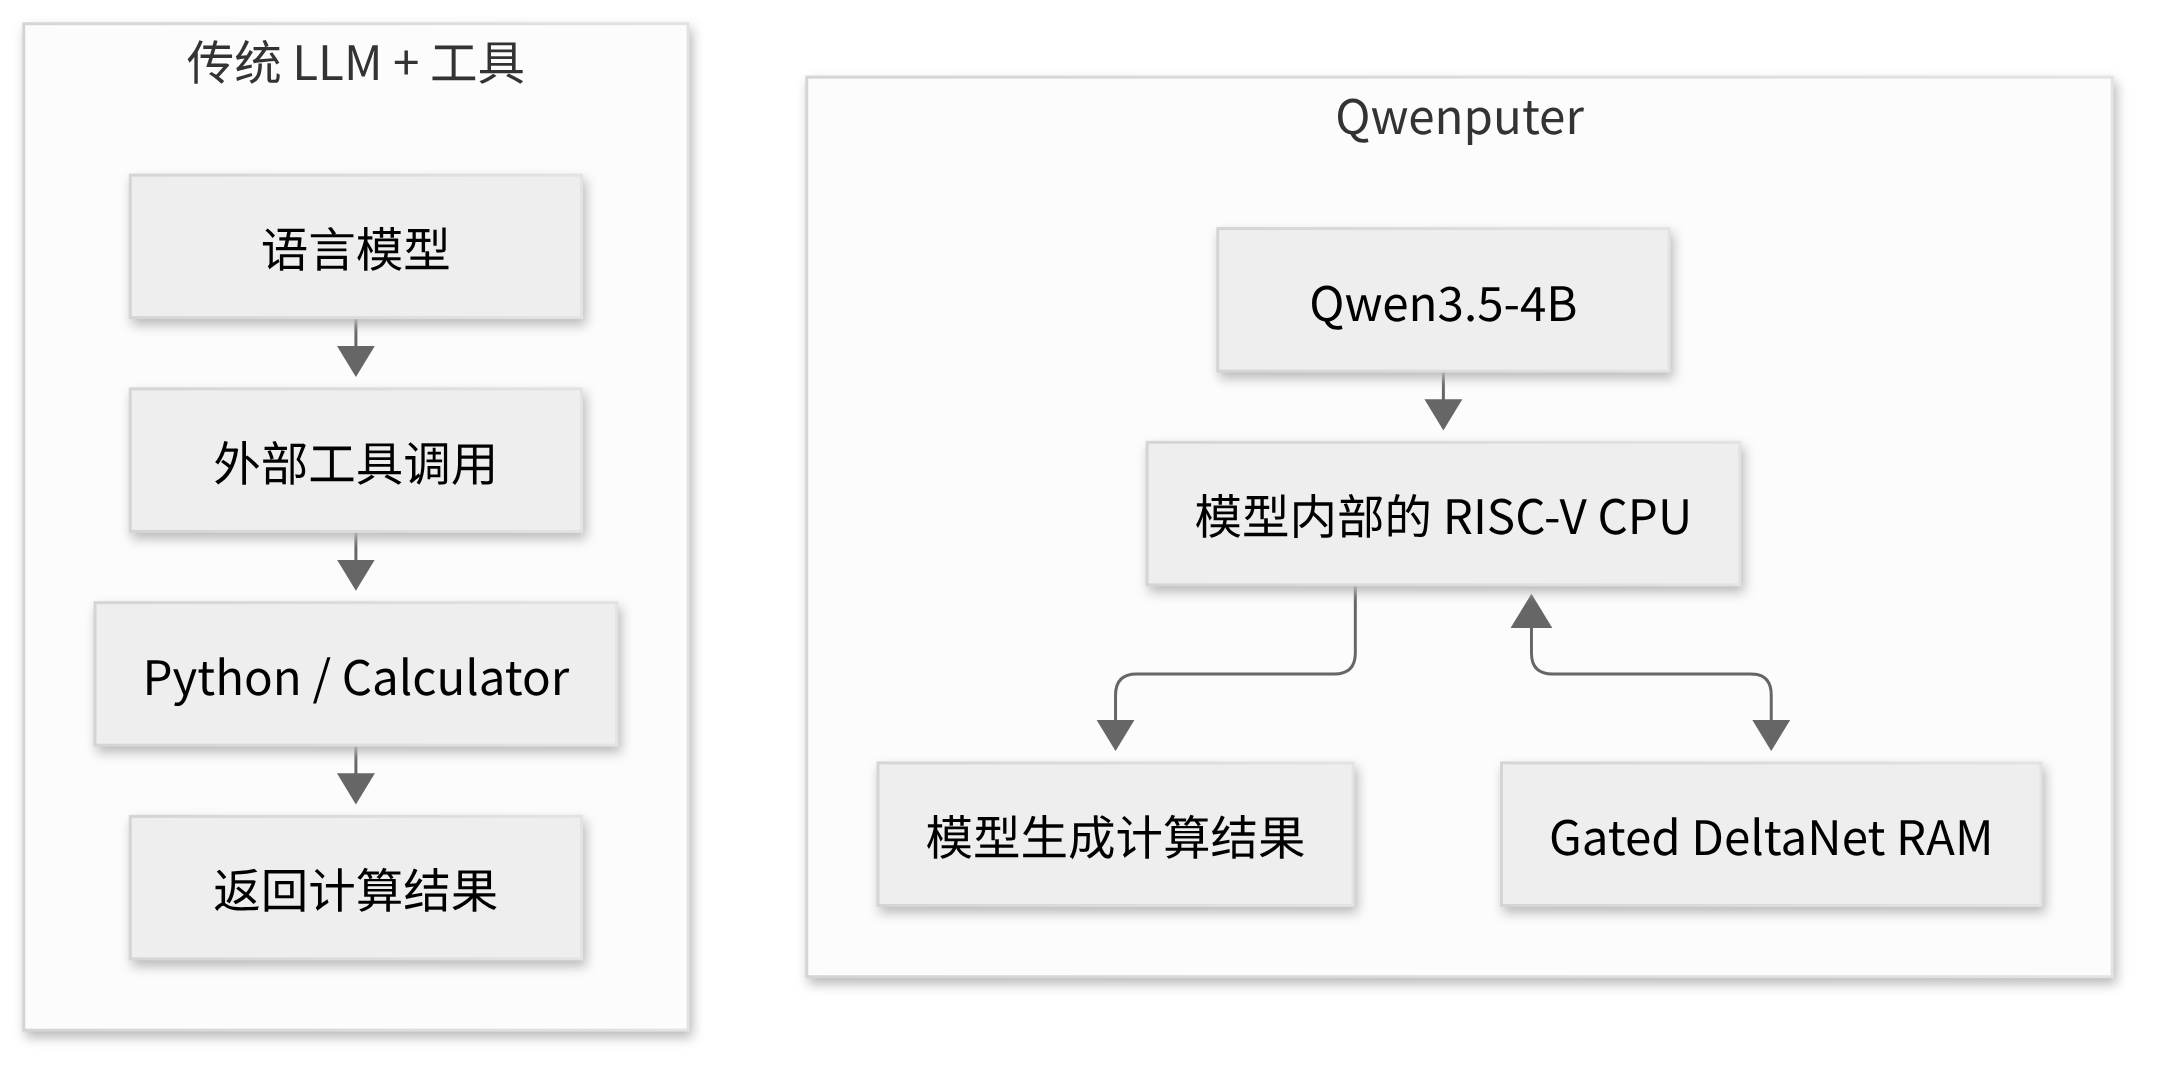
例如,让模型计算:
123456789 × 987654321普通的 Qwen 可以利用语言模型的能力逐步计算,也可以调用外部计算器。
Qwenputer 则可以通过模型内部的 RISC-V CPU 执行确定性的整数运算,最终得到:
121932631112635269需要区分的是,Qwen 仍然负责判断什么时候需要计算、应该计算什么。CPU 只负责按照明确的指令规则执行运算。
这意味着概率式的语言模型和确定性的计算电路,可以存在于同一份模型权重中。
二、最关键的突破:把 Gated DeltaNet 变成真正的 RAM
这是理解整个 Qwenputer 的核心,也是我认为最有技术价值的部分。
1. Gated DeltaNet 原本是干什么的?
我们熟悉的标准 Transformer 使用 Attention 机制来处理上下文。
在自回归推理过程中,模型通常会保存历史 Token 的 Key 和 Value,也就是 KV Cache。
随着上下文变长,需要保存的 KV Cache 也会越来越大。
Gated DeltaNet 采用了另一种方式。
它是一种带有门控更新机制的线性递归网络。每个 Head 维护一个固定大小的状态矩阵,随着 Token 的输入不断更新。

两者最直观的区别是:
- 标准 KV Cache 随着历史 Token 数量增加而增长。
- Gated DeltaNet 的递归状态矩阵大小固定,每个 Token 都在更新已有状态。
Qwen3-Next 和 Qwen3.5 采用混合注意力架构,其中约四分之三的 Attention 层使用 Gated DeltaNet。
一般情况下,这些状态矩阵保存的是模型学习到的连续向量信息,无法直接像计算机 RAM 那样通过地址精确读写。
作者发现,只要对 Gated DeltaNet 做一些特殊设置,就能让它具有 RAM 的行为。
2. 如何实现精确的内存读写?
Gated DeltaNet 的状态更新可以用一个简化公式表示:
$$ S_t = \alpha_t S_{t-1} + \beta_t k_t(v_t^\top - k_t^\top S_{t-1}) $$
其中:
- $S$:状态矩阵,可以理解为内存。
- $\alpha$:遗忘门,决定旧数据保留多少。
- $\beta$:写入强度。
- $k$:用来选择写入位置的向量。
- $v$:要写入的数据。
作者将两个关键参数固定为:
$$ \alpha=1,\qquad \beta=1 $$
然后把 Key 设置为 One-hot 向量。
One-hot 向量非常简单,例如:
[0, 1, 0, 0]这个向量只有第二个位置为 1,其余位置都是 0。
当它作为寻址向量时,意味着只选择状态矩阵中的第二行。
假设我们有这样一块内存:
| 内存地址 | 写入前 | 写入后 |
|---|---|---|
| 0x00 | 10 | 10 |
| 0x01 | 20 | 99 |
| 0x02 | 30 | 30 |
| 0x03 | 40 | 40 |
当 One-hot Key 指向地址 0x01,写入值为 99 时,只有对应位置的数据发生变化。
因为 $\alpha=1$,其余位置的旧数据会完整保留。
因为 $\beta=1$,目标位置会直接使用新数据覆盖旧数据。
读取时,使用同样的 One-hot Query,就可以从对应位置读出保存的值。
这样,原本用于保存模型上下文信息的状态矩阵,就具备了类似下面的能力:
memory[address] = value;   // WRITE

value = memory[address];   // READ
真实的实现还涉及 Head 分配、地址编码以及数值精度控制,不过核心原理就是这样。
更重要的是,这块 RAM 并不需要随着上下文长度增长而持续增加存储空间。
作者利用多个 Gated DeltaNet Head,构造出了 CPU 需要的 RAM、寄存器、程序计数器等状态存储。
这项工作的关键意义,是证明了神经网络内部的递归状态可以被构造成可靠、可寻址的存储设备。
当然,这种能力来自特殊构造的权重和受控的数值表示。普通 Qwen3.5 中的 Gated DeltaNet 并不天然支持这种精确读写。
三、第二个突破:CPU 电路可以直接编译成模型权重
有了 RAM,下一步就是构造 CPU。
传统 CPU 由寄存器、ALU、控制单元等组件组成。
执行一条指令时,需要完成一系列操作,例如读取寄存器、执行算术运算、写回结果、更新程序计数器。
作者的思路是将这些硬件操作转化成神经网络可以表达的数学运算。
| 传统 CPU 组件 | Qwenputer 的实现方式 |
|---|---|
| 寄存器 | Gated DeltaNet 状态 |
| RAM | 多个 Gated DeltaNet Head |
| ALU | MLP / SwiGLU 电路 |
| 指令解码 | 神经网络层中的逻辑电路 |
| 程序计数器 PC | 专门的状态存储 |
| CPU 时钟推进 | Token 解码过程 |
实际实现使用了 11 层新增的计算电路,放在原始 Qwen3.5-4B 的 32 层之前。
这颗 CPU 支持 RV32IM 指令集、Zba 扩展,以及额外的大整数运算单元。
作者的技术文档还给出了相关存储空间:
- RAM:32 KB。
- 只读数据区 DROM:128 KB。
- 程序 ROM:256 KB。
为什么 MLP 能模拟 CPU?
因为神经网络中的线性变换和非线性激活,可以组合出确定性的逻辑函数。
例如,对于两个二进制输入 $a,b$,可以通过适当设计的网络权重来实现 AND、OR、XOR 等逻辑。
进一步组合这些逻辑,就能构造加法器、比较器、移位器等组件。
只要能实现这些基本操作,再配合寄存器和指令控制,就有机会组成完整的 CPU。
作者将 CPU 定义为一系列基本操作,然后交给编译器处理:
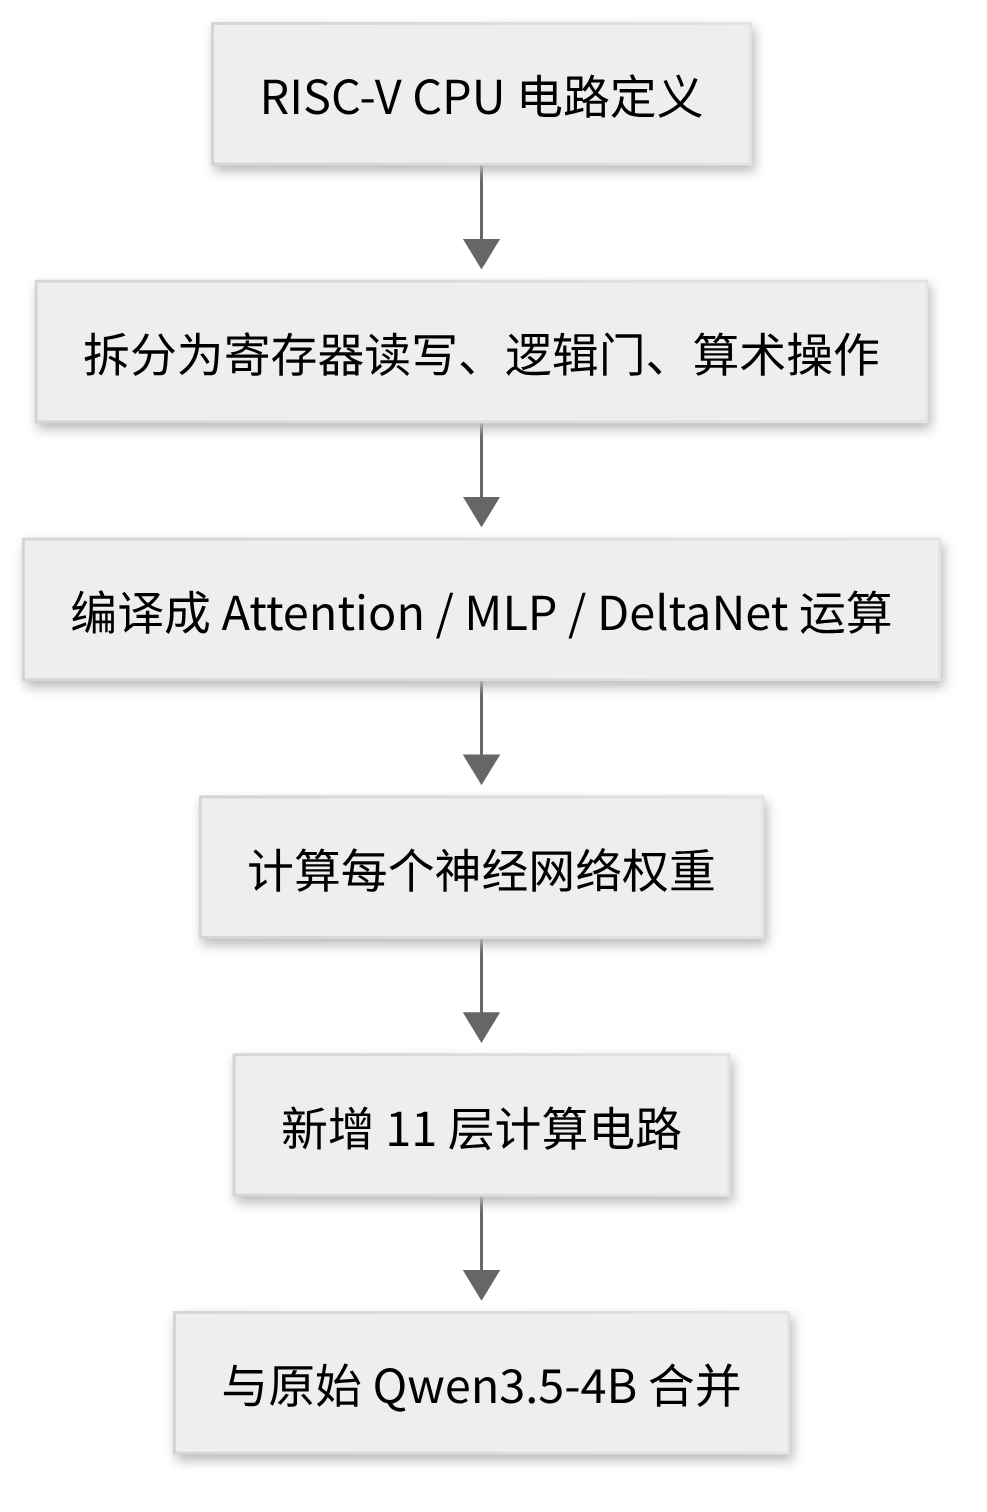
这里最特殊的一点是:整个 CPU 的权重由编译器直接计算,没有经过梯度下降训练。
原始 Qwen3.5-4B 的权重则保持不变。
换句话说,模型中出现了两种不同来源的能力:
一种来自预训练,通过大量数据学习获得语言理解、知识和推理能力。
另一种来自编译器,通过直接设计权重获得确定性的程序执行能力。
这也是这项研究被称为 Compiled Weights 的原因。
它让我们看到,神经网络权重除了保存训练获得的能力,也可以用于承载人类直接设计的计算电路。
四、第三个关键设计:Token 生成过程就是 CPU 的执行过程
CPU 已经放进模型了,那么它是怎么运行的?
答案是通过模型的自回归 Token 解码过程。
作者设计了一套特殊的 Token 协议,让每次模型前向传播都能够推动 CPU 执行。
其中包含三类重要的 Token:
| Token | 作用 |
|---|---|
ADDR |
指定需要写入的内存位置 |
VAL |
提供需要写入的数据 |
STEP |
标记一次指令执行步骤的完成 |
CPU 在执行过程中,会持续生成这些特殊 Token,形成执行 Trace。
模型每生成一个相关 Token,计算电路就执行对应的操作,并更新 Gated DeltaNet 中保存的状态。
Qwen 怎么知道什么时候应该调用 CPU?
作者借用了 Qwen 原本就熟悉的 Tool Calling 格式。
例如:
用户:123456789 * 987654321 等于多少?

Qwen:
<tool_call>
calc("123456789 * 987654321")
</tool_call>
对于普通的 Tool Calling,外部程序需要解析模型生成的调用,然后启动 Python 或其他计算工具。
在 Qwenputer 中,计算电路会接收这个调用,执行计算,再由模型内部生成工具响应。
整体过程大致如下:
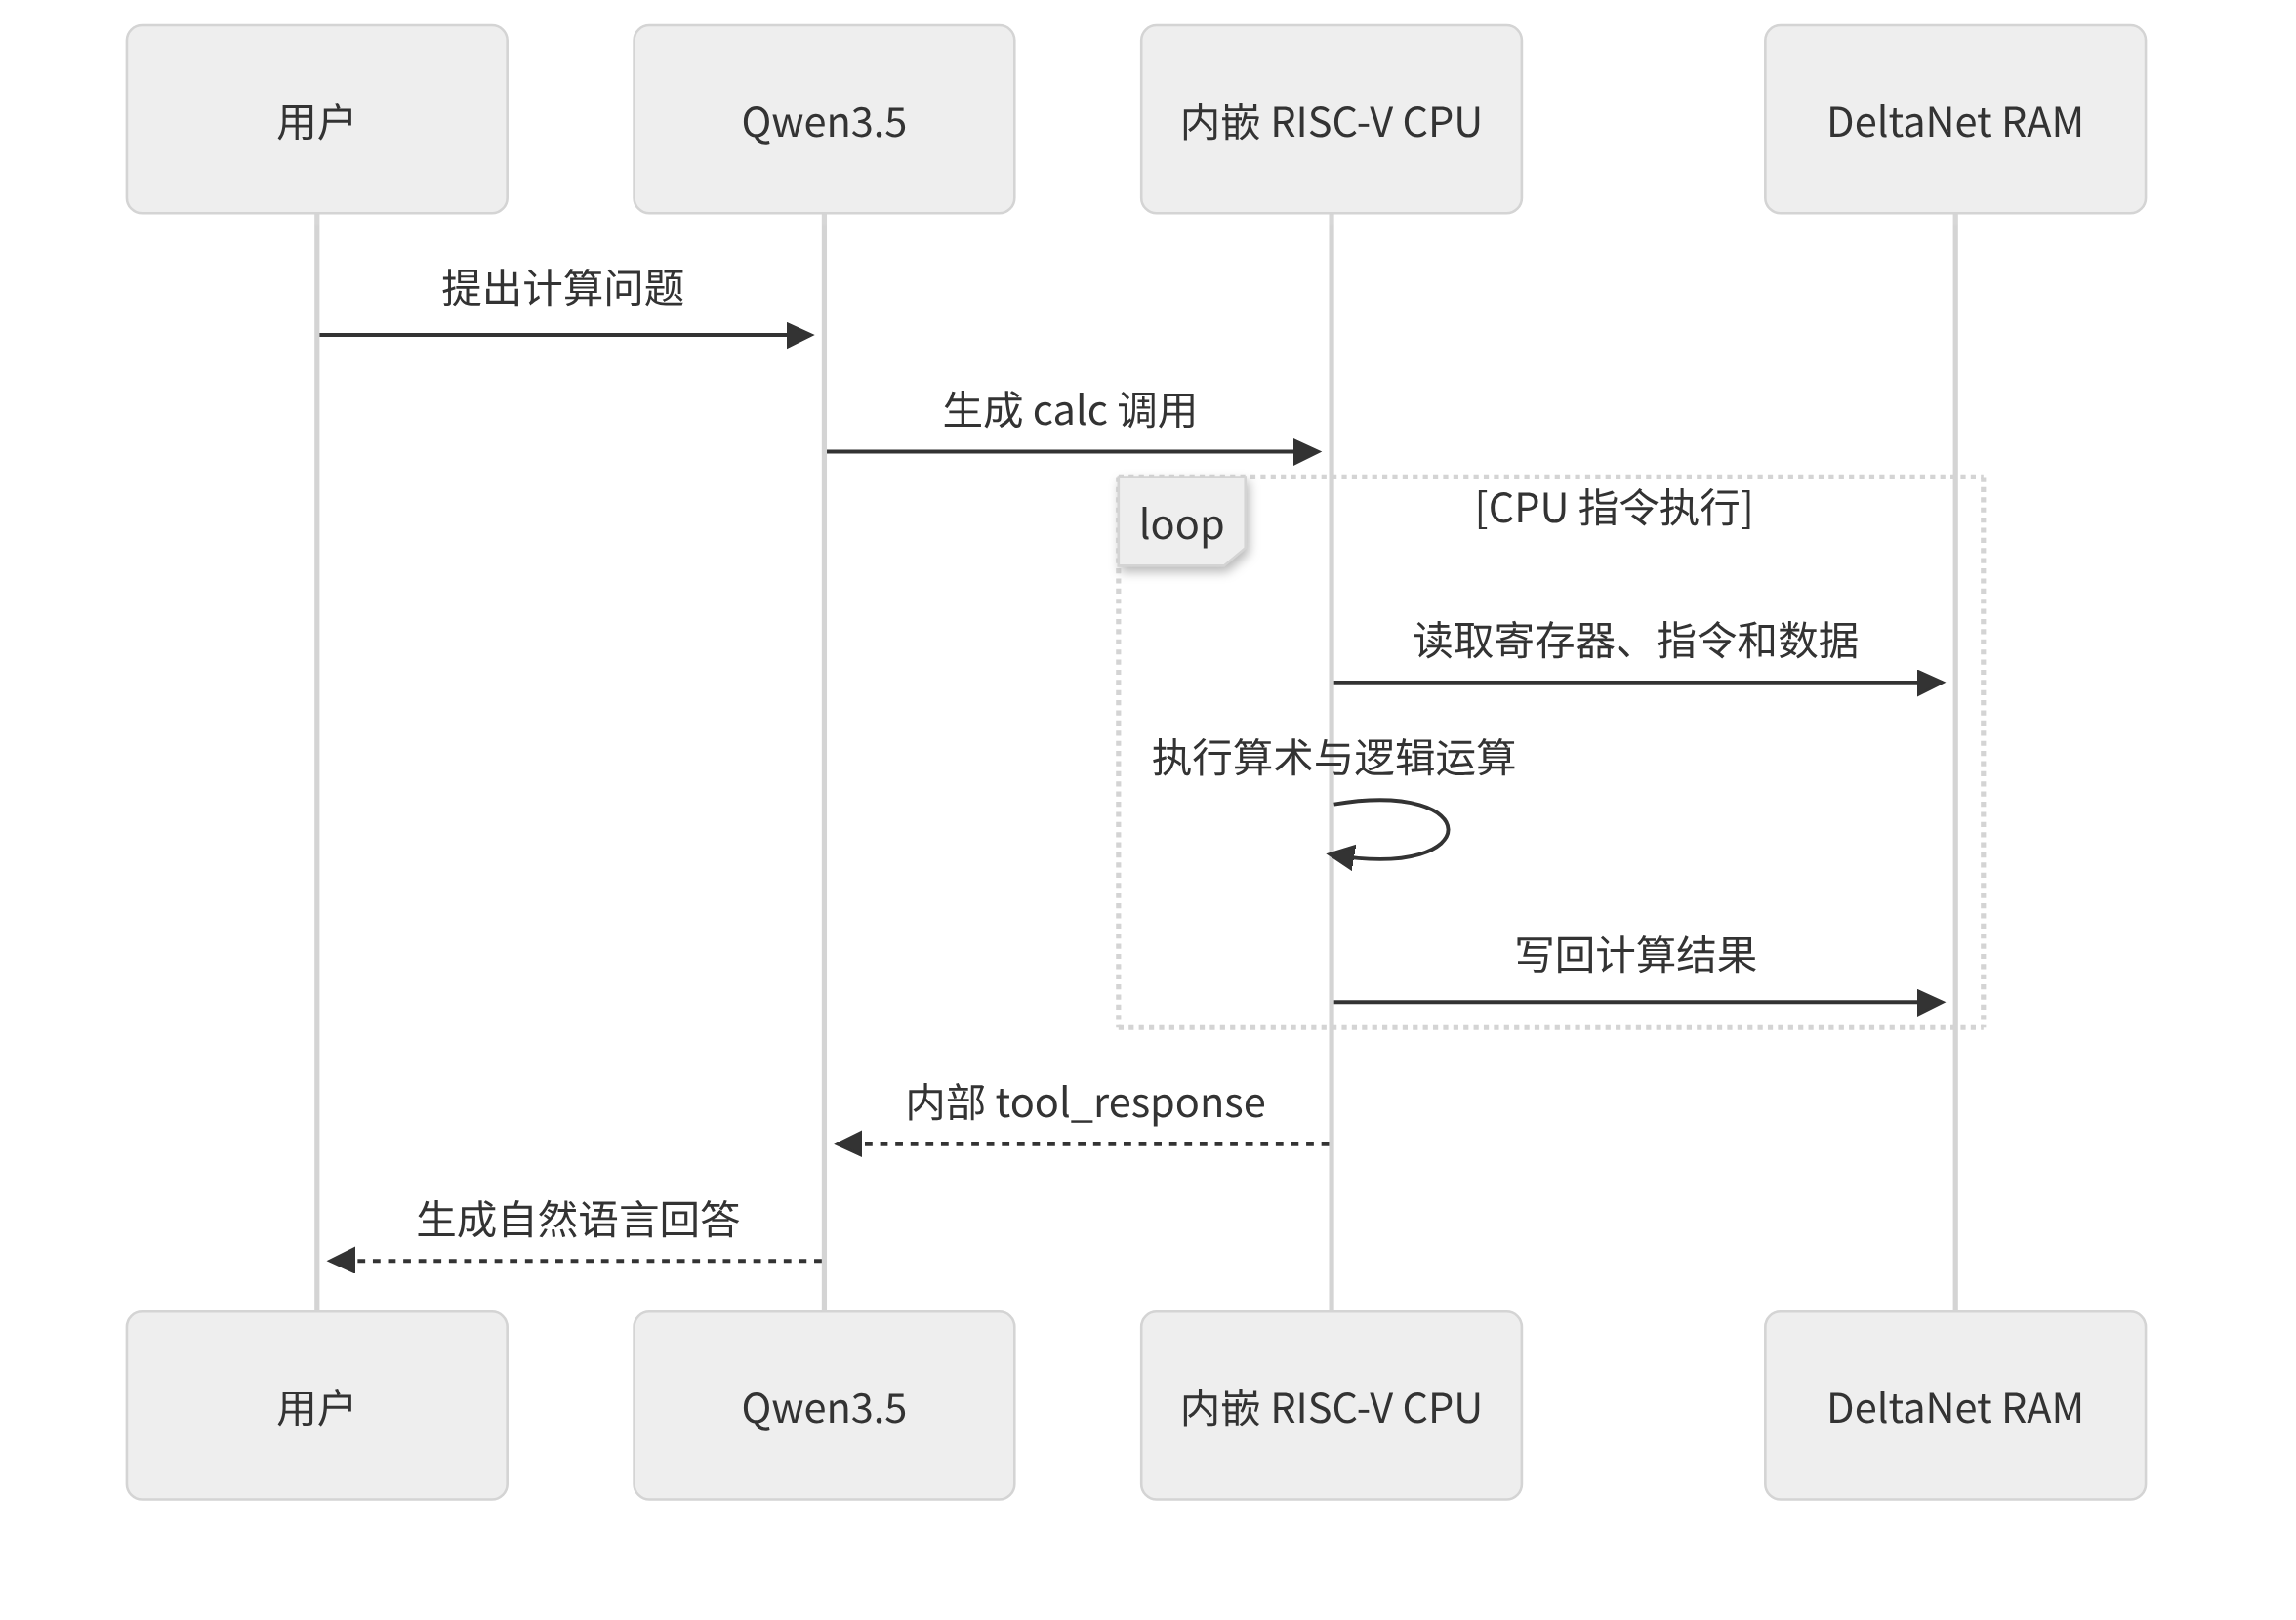
所以从外部看,Qwenputer 好像在调用一个普通的计算器工具。
但实际上,计算发生在模型内部的神经网络计算层中。
为了加载固件和管理执行状态,当前实现还使用了一个名为 RvChat 的轻量驱动。它负责初始化内存,并让 CPU 的执行 Trace 不干扰原始 Qwen 的正常语言推理。
因此,当前版本仍然需要专门的运行驱动,暂时还无法直接通过标准 generate() 完成整个执行过程。
CPU 计算会很快吗?
恰恰相反。
因为每条 CPU 指令都需要经过模型的 Token 解码过程,其执行效率远低于真实 CPU。
作者通过优化后的 Triton Executor,在 NVIDIA L4 GPU 上实现了大约 3,200 个 CPU Trace Token/s。
这个数字看起来不低,但需要考虑,一条 CPU 指令可能需要消耗多个 Token,完成复杂计算还需要执行大量指令。
因此,一次复杂计算可能需要数秒钟,而普通 CPU 通常能够在毫秒甚至更短时间内完成。
现阶段,这种方式并不具备计算性能上的竞争力。
五、实验效果怎么样?
作者首先验证了 CPU 本身能否正确运行。
根据公开的实验结果:
- 通过了官方 RISC-V 指令测试。
- 测试程序的执行结果与 QEMU 一致。
- 累计约 1,800 万条指令的自由运行测试没有发现错误。
- 约 23 万个由计算电路控制的输出位置,与参考实现对比没有发现不一致。
其中,自由运行意味着 CPU 根据自己之前的执行结果继续执行,不需要参考模拟器在每一步纠正状态。
这说明它已经具备执行较长程序的能力。
不过,这些是作者报告的实验结果,尚不能视为对所有输入和执行环境的形式化正确性证明。
数学任务的准确率
作者使用 DeepMind 算术测试集以及 NUPA 长整数运算测试,比较了原始 Qwen3.5-4B、Qwenputer,以及配备外部 Python 工具的 Qwen3.5-4B。
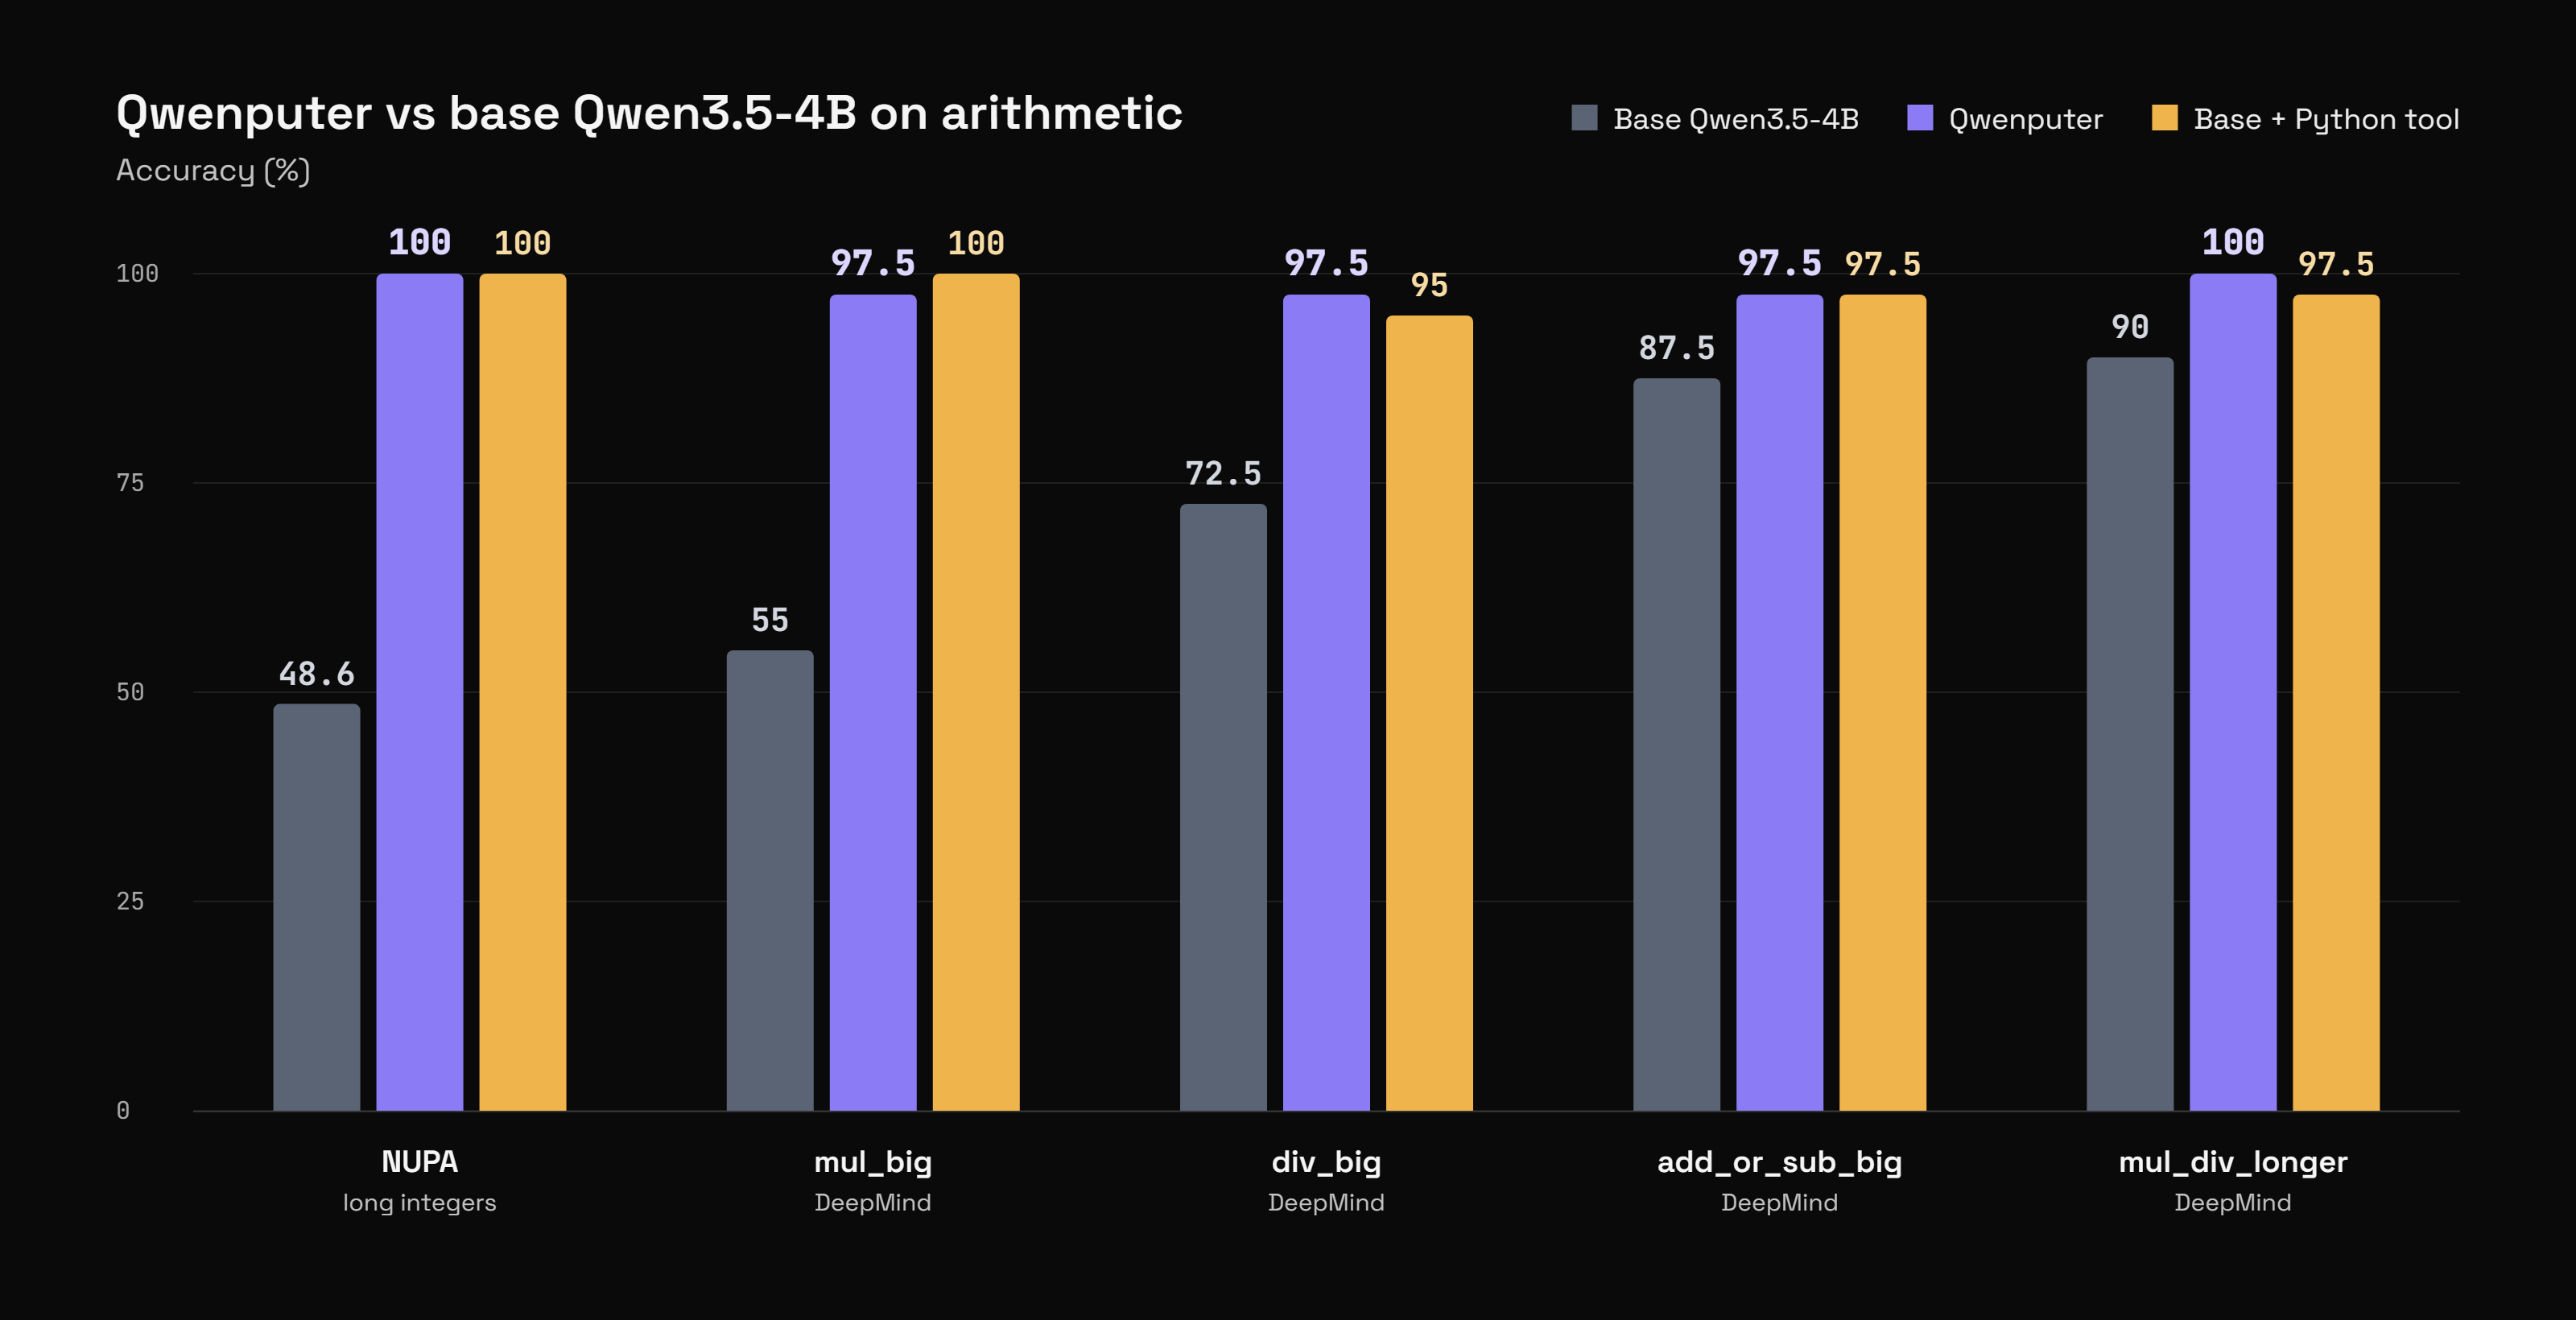
图:Qwenputer 算术任务准确率对比。来源:Divyansh Agrawal,Qwenputer 原文。
其中,DeepMind 测试结果如下:
| 测试任务 | 原始 Qwen | Qwenputer | Python 工具 |
|---|---|---|---|
| 大整数乘法 | 55% | 97.5% | 100% |
| 大整数除法 | 72.5% | 97.5% | 95% |
| 长混合乘除 | 90% | 100% | 97.5% |
| 大整数加减 | 87.5% | 97.5% | 97.5% |
DeepMind 各任务测试集每组 40 道题。这里的准确率是整个模型完成题目的准确率,而非 CPU 指令正确率。
可以看到,在这些任务中,Qwenputer 的表现已经非常接近配备外部 Python 工具的 Qwen,个别测试甚至略高。
在 NUPA 长整数运算测试中,准确率从原始 Qwen 的 48.6% 提升到了 100%,与配备外部 Python 工具的结果一致。
但这里有一个很重要的细节。
即使 CPU 本身能够正确计算,整个模型也无法保证每道题都答对。
因为 Qwen 仍然需要判断应该计算什么、如何调用计算器,以及怎么使用计算结果。
作者就发现过这样的失败情况:CPU 已经返回正确答案,但 Qwen 又重新进行推理,最后给出了错误结果,或者陷入反复调用工具的循环。
所以,CPU 解决的是确定性执行问题,并没有消除语言模型本身的概率性。
原来的问答能力会受到影响吗?
这是另一个值得关注的问题。
Qwenputer 依然可以正常聊天、解释代码、回答知识问题和进行逻辑推理。
因为作者保留了原始 Qwen3.5-4B 的权重,新增的计算电路也会在正常文本生成时尽量避免干扰语言模型。
早期 CHIP-8 版本的 MMLU 测试结果是:
| 模型 | MMLU 准确率 |
|---|---|
| 原始 Qwen3.5-4B | 71.7% |
| Qwenputer CHIP-8 | 71.9% |
RISC-V 版本也进行了文本行为一致性测试,其输出分布与原始 Qwen 的偏差较小。
目前的证据表明,加入计算电路基本保留了原有语言能力,但并没有证明模型在一般逻辑推理、代码理解等任务上获得了普遍提升。
也就是说,它仍然是一款能够正常问答和推理的语言模型,只是在需要精确计算时,多了一项内部计算能力。
六、另一个有意思的实验:模型内部的文件系统
除了 CPU,作者还做了一个非常有意思的扩展:在模型内部构造文件系统。
既然 Gated DeltaNet 已经能够作为 RAM 使用,那么就可以继续实现结构化的数据存储。
作者在实验分支中增加了五类操作:
put("name", "Alice")
get("name")
append("notes", "New information")
list()
delete("name")
这些操作同样由模型内部的计算电路执行,不需要外部数据库或文件系统服务。
文件名经过哈希后映射到 Gated DeltaNet 状态中的目录位置,文件内容则保存在其他状态矩阵中。
当前实验版本支持最多 512 个文件,总容量大约相当于 53,000 Token 的文本。
这对 Agent Memory 有什么意义?
传统 Agent 的记忆系统一般会使用独立的存储服务:
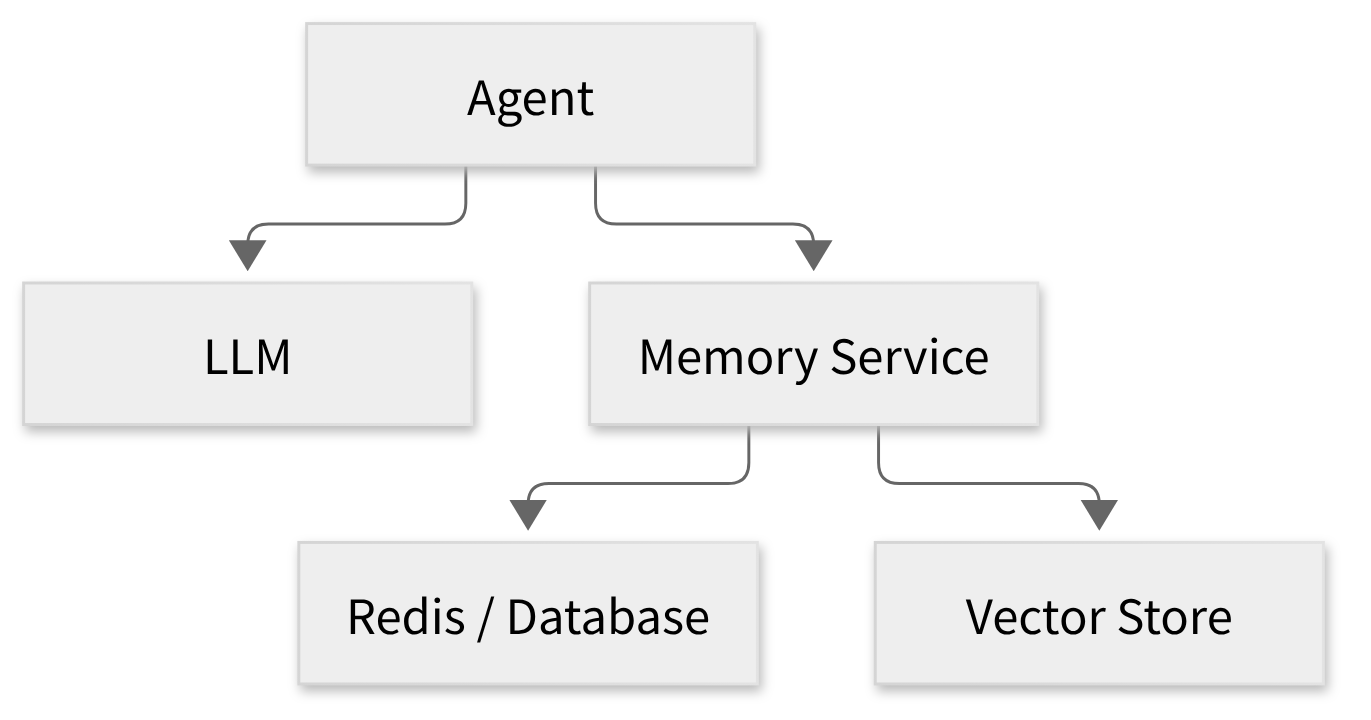
Qwenputer 探索了另一种可能:
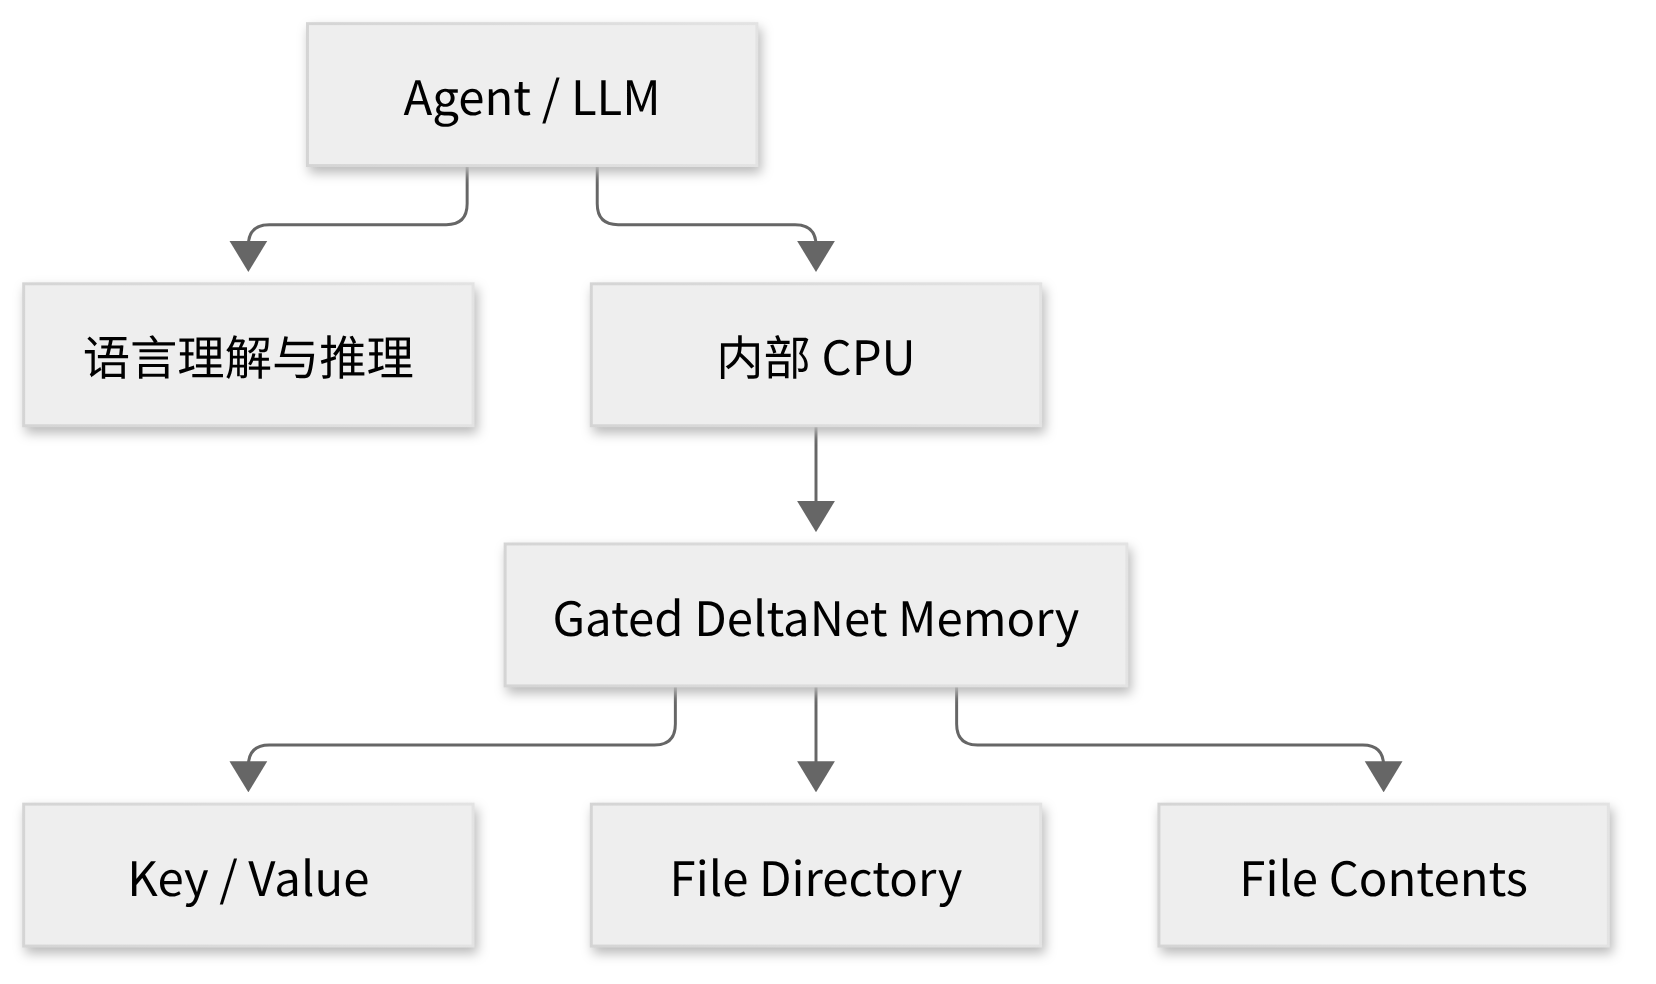
尤其有意思的是,这些记忆可以跨对话保存。
因为文件数据保存在 Gated DeltaNet 的状态矩阵中,所以只要保存这些运行状态,再在下一次对话时恢复,就可以重新访问之前保存的文件。
这里需要注意,动态信息没有通过重新训练写入模型参数。
模型权重提供读写能力,运行时状态负责保存具体数据。
作者还设计了跨对话记忆测试。
在一组事实更新问题中,Qwenputer 文件系统版本达到 90% 的准确率,使用过去聊天记录作为上下文的对照方法为 30%。另一组跨会话回忆测试中,文件系统版本达到 83.3%,配备外部 Python Memory 工具的对照结果为 78.9%。
样本量目前仍然有限,但这一实验说明模型的内部递归状态具有承担显式记忆的潜力。
当然,这种方式距离真正的生产级 Memory 系统还有很长的路。
持久化、并发、事务、权限隔离和故障恢复等问题,都没有因为将数据放进模型状态而自动解决。
不过从模型架构的角度来看,这是一种值得研究的新方向。
七、这项技术目前有哪些局限?
Qwenputer 目前仍然是一个实验性项目。
首先是性能。
通过 Token 生成推进 CPU 指令执行,开销远高于普通 CPU。对于实际应用,调用外部 Python、Java 或原生计算库通常更有效率。
其次是模型体积。
由于新增了计算电路和更宽的隐藏维度,完整模型的 BF16 Checkpoint 约为 18.8 GB,接近原始模型的两倍。作者指出,其中相当大一部分空间属于零填充。
第三是运行兼容性。
当前版本需要 RvChat 驱动来加载固件、管理状态以及隔离 CPU Trace,还无法完全依靠通用的模型推理流程工作。
最后是软件生态。
虽然底层 RISC-V CPU 已经运行过 C 和 MicroPython 程序,但 MicroPython 目前主要在独立计算核心上通过测试,尚未完整接入合并后的对话模型。
作者下一步计划让 Qwen 能够直接生成 Python 代码,再通过内嵌的 MicroPython 执行。
所以,现阶段的 Qwenputer 已经证明了在神经网络内部执行 CPU 指令的可行性,但还不能将其视为一个通用的模型内部代码执行环境。
八、我认为 Qwenputer 真正的意义
读完这篇文章,我认为其中最值得关注的,其实并不是「Qwen 可以在内部运行一颗 CPU」这个结果。
CPU 是一个非常直观的验证案例,它背后的三个方向可能更有研究价值。
1. 神经网络权重可以承载编译出来的程序
传统大模型的能力主要来自训练。
我们通过数据让模型学习语言、知识、逻辑和代码。
Qwenputer 展示了另一种获得模型能力的途径:通过编译器直接设计神经网络权重,使其执行特定的确定性功能。
例如,让模型内部具备经过明确设计的算术电路、数据校验电路或者特定格式的解析能力。
这些功能不一定需要重新训练整个模型。
从这个角度来看,未来的模型可能同时包含学习得到的能力,以及由编译器生成的确定性模块。
2. 模型内部的状态空间可能承担更多职责
Gated DeltaNet 原本用于维护语言模型处理上下文时的递归状态。
Qwenputer 证明,只要以恰当的方式设计权重,这些状态就能够充当精确、可寻址的存储空间。
这对未来的模型原生 Memory 有一定启发。
部分状态负责语言理解,部分状态负责结构化数据存储,甚至可能有专门的状态用于执行确定性的程序。
当然,目前还不能推断这种架构会取代数据库或者外部记忆服务,但至少证明了相关能力在神经网络内部实现的可能性。
3. 确定性计算可以深入模型内部
目前大多数 Agent 架构采用的是模型与工具分离的方式。
LLM 负责理解和决策,外部程序负责实际执行。
这种架构成熟、灵活,也更适合今天的大多数工程场景。
Qwenputer 则尝试让某些确定性的执行能力直接成为模型计算过程的一部分。
作者还在此基础上研究了两个问题:
一是模型是否可以将推理信息保存在 RNN 状态中,从而绕过传统的思维链监控。
二是能否将监控逻辑编译进模型权重,构造模型自身难以随意关闭的内部监控机制。
这两个方向都说明,精确控制模型内部的状态和计算路径,可能有远超数学运算的研究价值。
最后
如果从实际工程的角度看,Qwenputer 目前的性能、体积和运行复杂度都不具备明显优势。
让模型调用一个 Python 工具,显然比在神经网络里执行数千条 RISC-V 指令更加高效。
但这项研究的意义在于,它证明了以前很少有人真正实现过的一种可能性:
神经网络既可以通过训练学习语言和推理能力,也能够通过直接构造权重,拥有确定性的计算电路和可编程的状态存储。
从最初的逻辑门,到加法器、寄存器、RAM,再到完整的 RISC-V CPU 和实验性的文件系统,作者实际上是在探索将传统计算机体系结构映射到神经网络内部的可行性。
我认为,Qwenputer 最值得关注的两个成果,是将 Gated DeltaNet 构造成精确可寻址 RAM,以及通过编译器直接生成可执行逻辑的模型权重。
至于最终能否发展出更实用的计算和记忆架构,还需要后续研究。
但至少这一次,作者已经让一款能够正常聊天的大语言模型,在自己的神经网络里运行起了一颗真正遵循 RISC-V 指令语义的虚拟 CPU。