多开子 agent,代码就写得更好吗
目前很多智能体产品都已经支持主 agent 主动拉起一批子 agent 并行干活,但多智能体协同实际效果怎样,是不是一定比单 agent 好,很少有人会特地去对比一下。
最近读到一篇论文,做的正是这件事:《When Sub-Agents Work in Parallel: The Promises and Pitfalls of Dynamic Concurrency in Long-Horizon Coding Tasks》,https://arxiv.org/abs/2610.10263 。研究来自南京大学、中央财经大学和伊利诺伊大学厄巴纳-香槟分校,作者是 Han Li、HanHaoNing Li、Ziqian Jiang 和 Yiling Lou。他们把 Codex、Claude Code、Kimi Code 三个 coding agent 自带的子 agent 并发功能分别打开和关掉,在 354 个任务上各跑一遍,一共 2,124 次运行,记录下来的 token 有 112 亿,按标准 API 价格折算是 20,780.02 美元。
结论有好有坏。任务越长,并发越可能有收益;SWE-bench Verified 这类短任务上,Claude Code 和 Kimi Code 打开并发后通过率掉了 24 和 18 个点。token 用量是串行的 1.41 到 3.31 倍,耗时多数情况下也更长。整篇论文绕着一个问题:子 agent 并行跑起来以后,主 agent 能不能把它们的结果用上。
接下来大致按照背景、实验设计、结果、失败分类、启发的顺序拆一遍。
背景与问题
早一些的 coding agent,比如 TRAE(论文引用的是字节跳动开源的软件工程 agent Trae Agent)和 OpenHands,做多 agent 协作时多用固定流程:几个子 agent、什么角色、谁做哪块、在哪里同步,都提前写死。这种做法在结构清楚的任务上好用,代价是开发者得在开始前就想好怎么拆。很多任务的依赖关系做到一半才看得清,提前拆好的流程就不合用了。
论文研究的「动态并发」,指主 agent 在执行中根据任务进展,自己决定要不要拉起子 agent、什么时候拉、分什么活,再负责收结果、对齐共享的接口和文件、验证整合后的产物。
作者指出,已有评测大多看单 agent 或固定协议的多 agent 系统,任务也多是 SWE-bench 这种只需几十行补丁的有边界任务;动态并发瞄准的却是从零生成仓库、连续多版本开发这类要写数万行代码的长任务。论文问了四个问题:结果和资源消耗怎么变,子 agent 怎么分派,会出哪些失败,什么条件下有好处。
实验怎么做
三种并发机制
下面这张图来自论文图 1,画的是三个 agent 各自怎么派活。
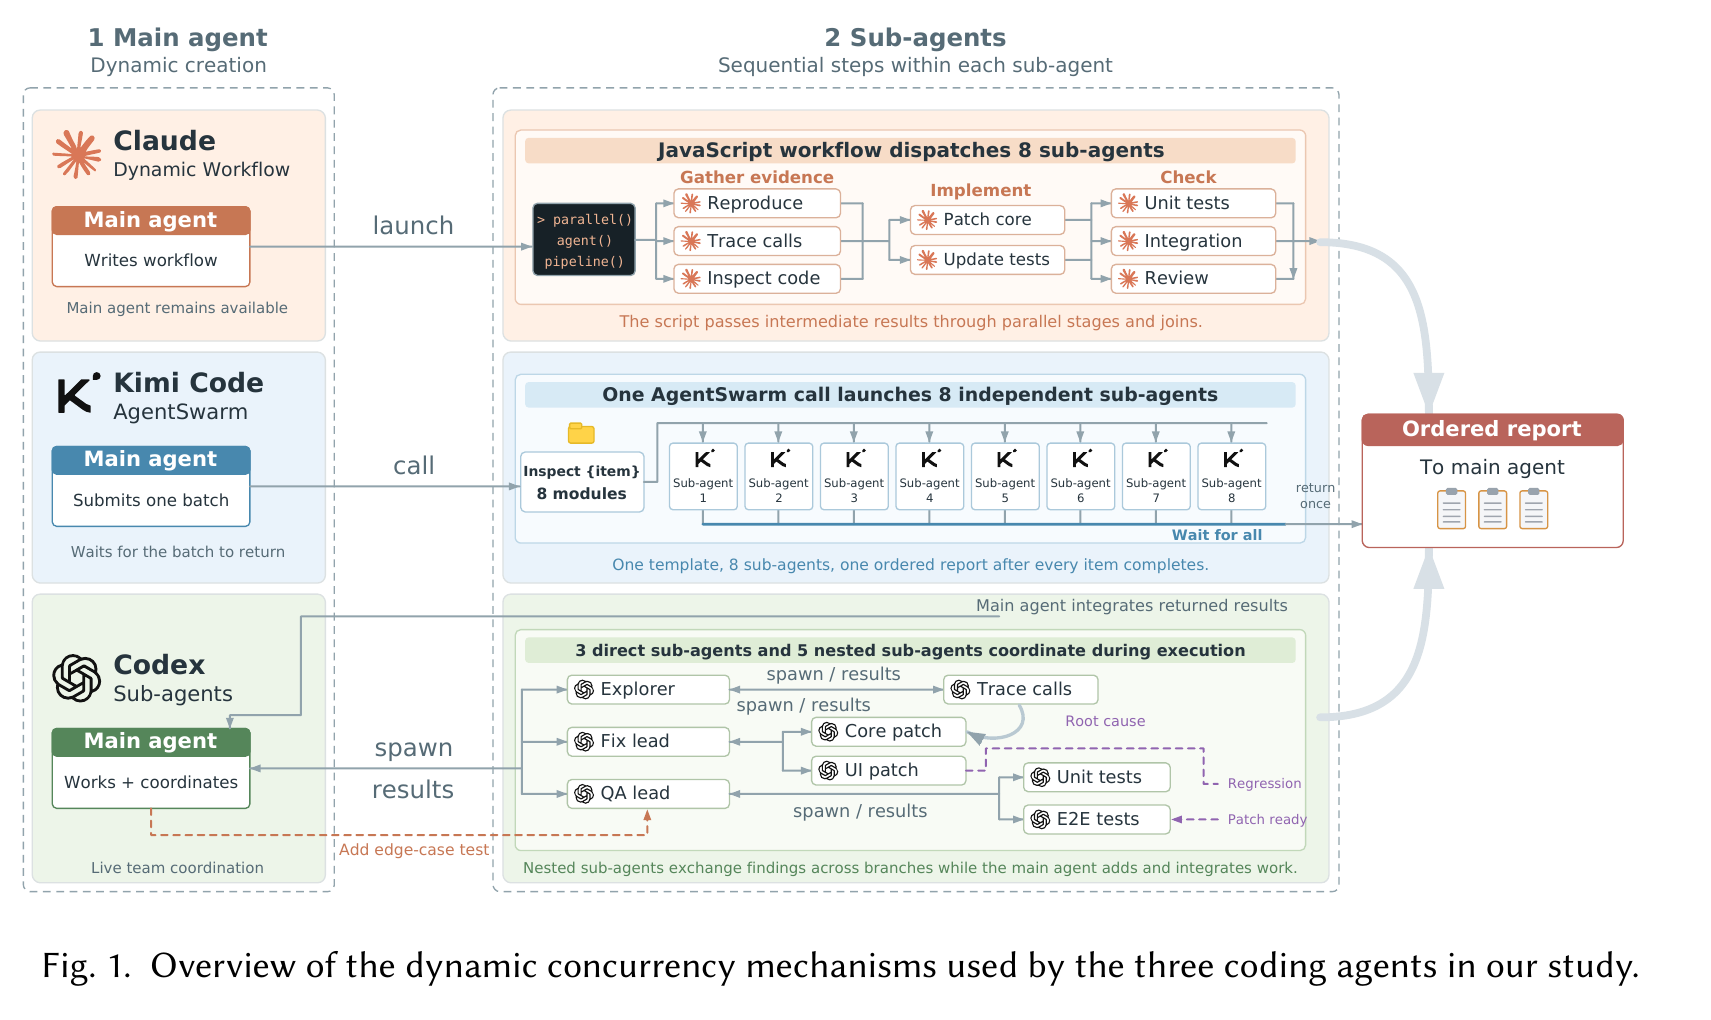
最上面是 Claude Code 的 Dynamic Workflow。主 agent 先写一段 JavaScript 工作流脚本,用 parallel()、agent()、pipeline() 安排几个并行阶段和汇合点。图里的例子派了 8 个子 agent,分三段:收集证据(复现、追踪调用、检查代码),实现(修核心代码、更新测试),检查(单元测试、集成测试、评审)。中间结果由脚本在阶段间传递,主 agent 期间仍可响应。论文里 Claude Code 通过 ultracode 打开这个功能。
中间是 Kimi Code 的 AgentSwarm。主 agent 一次调用提交一整批任务,子 agent 从同一个模板生成、各自分到不同条目,图里是检查 8 个模块。主 agent 等全部完成,再一次性拿回一份按顺序排好的报告。打开方式是 swarm_mode=true。
最下面是 Codex 的 multiagent v2。子 agent 可以再往下派,图里有 3 个直接子 agent(探索、修复负责人、测试负责人)和 5 个嵌套子 agent,嵌套的子 agent 会跨分支交换发现。主 agent 一边派活一边自己干活,还和子 agent 互发消息。打开方式是 multi_agent 和 multi_agent_v2 两个选项。
三个 agent 都配自家模型:Codex 配 GPT-5.4,Claude Code 配 Claude Opus 5,Kimi Code 配 Kimi K3,组合在 2026 年 7 月选定,推理强度开到最高。作者的理由是,模型在强化学习后训练中可能已适应自家 harness 的工具接口,换模型可能会破坏这种适配。
五个基准
四个长任务基准分别是:
- RepoZero,包含两类任务,Py2JS 要求用 JavaScript 重建 Python 包,C2Rust 要求用 Rust 重建 C 接口;
- ProgramBench,只给参考可执行文件和文档,要求从头重建一个完整的命令行程序;
- NL2Repo,从自然语言需求和一个空目录出发,建出整个仓库;
- LoopsBench,在同一个仓库里连续完成多个互相依赖的开发阶段。
对照组是 SWE-bench Verified,在现有仓库里修一个具体 issue,代表有边界的短任务。作者在每个基准原有的难度分组里分层随机抽样,长任务基准抽 25%,SWE-bench Verified 抽 20%,论文表 1 的结果如下:
| 基准 | 全集 | 抽样 | 易 | 中 | 难 | 运行次数 |
|---|---|---|---|---|---|---|
| SWE-bench Verified | 500 | 100 | 39 | 52 | 9 | 600 |
| Py2JS | 400 | 100 | 33 | 32 | 35 | 600 |
| C2Rust | 200 | 50 | 15 | 18 | 17 | 300 |
| NL2Repo | 104 | 26 | 6 | 12 | 8 | 156 |
| ProgramBench | 200 | 50 | 7 | 36 | 7 | 300 |
| LoopsBench | 112 | 28 | 4 | 11 | 13 | 168 |
| 合计 | 1,516 | 354 | 104 | 161 | 89 | 2,124 |
每个任务用三个 agent、两种模式各跑一次,354 × 3 × 2 就是 2,124 次运行。论文图 3 画了各基准标准答案的代码行数:SWE-bench Verified 平均只有 14 行,RepoZero 约 2.5k 行,NL2Repo 约 3.8k 行,ProgramBench 约 8.4k 行,LoopsBench 平均约 26.8k 行。
怎么对照
两种模式下,模型、提示词、环境和时间预算都一致。并发模式用各家默认设置;串行模式里,Codex 关掉两个多 agent 选项,Claude Code 禁用 Workflow、Task 和 Agent 三个工具,Kimi Code 设 swarm_mode=false,保证不创建任何子 agent。指标有两个:任务通过率是完全解决的任务占比;测试通过率是每个任务通过测试的比例再取平均,能反映没做完的任务做到了几成。
实验结果
通过率:长任务有涨有跌
论文表 2 里的任务通过率(%,前为并发,后为串行):
| 基准 | Codex | Claude Code | Kimi Code |
|---|---|---|---|
| SWE-bench Verified | 71.0 / 71.0 | 59.0 / 83.0 | 59.0 / 77.0 |
| RepoZero | 40.7 / 40.0 | 26.7 / 42.7 | 38.7 / 37.3 |
| NL2Repo | 57.7 / 34.6 | 65.4 / 57.7 | 46.2 / 57.7 |
| ProgramBench | 0.0 / 0.0 | 0.0 / 0.0 | 0.0 / 0.0 |
| LoopsBench | 25.0 / 21.4 | 21.4 / 7.1 | 25.0 / 25.0 |
LoopsBench 是任务最长的基准,收益也最集中:Codex 从 21.4% 到 25.0%,Claude Code 从 7.1% 到 21.4%,涨了 14.3 个点,Kimi Code 没变。三个 agent 的测试通过率在 LoopsBench 上都有提高,最多高 6.0 个点(Codex 从 52.1% 到 58.1%)。
其他长任务基准上结果混杂。NL2Repo 上 Codex 从 34.6% 涨到 57.7%,Kimi Code 却从 57.7% 掉到 46.2%。ProgramBench 上任务通过率全是 0,按测试通过率算,Codex(53.5% 到 58.3%)和 Kimi Code(1.5% 到 1.7%)在并发下多做了一些。RepoZero 上 Claude Code 掉得最多,任务通过率从 42.7% 到 26.7%,测试通过率从 64.9% 到 41.5%。
同一基准内部也会互相抵消。Codex 在 RepoZero 上几乎没动,拆开看是 Py2JS 少解决 2 个、C2Rust 多解决 3 个,150 个任务净多 1 个,所以是 40.0% 到 40.7%。
短任务上并发没有带来提升:Codex 持平,Claude Code 从 83.0% 掉到 59.0%,Kimi Code 从 77.0% 掉到 59.0%。
作者把每个 agent 的全部任务合在一起做了精确 McNemar 检验,这种检验比较同一批任务在两种条件下的成败变化,再用 Holm 方法校正多次比较。结果是 Claude Code 和 Kimi Code 的整体下降显著(p 分别约为 5.1×10⁻⁷ 和 0.013),两家的整体下降包含长任务在内;Codex 的小幅上升不显著(p 约为 0.23)。按整体解决率算,三个 agent 的变化范围是下降 11.9 个点到上升 2.3 个点。
按代码规模排,三个 agent 平均后,并发减串行的测试通过率差值在 RepoZero 上是 −8.29 个点,NL2Repo −0.04,ProgramBench +1.24,LoopsBench +4.31,和平均代码规模从小到大的顺序一致。论文据此说,预期实现规模越大,并发的平均测试通过率优势越大。需要注意,这个趋势只来自四个基准的平均值。
两种模式解决的是同一批题吗
论文图 4 把每个 agent、每个基准的结果拆成四份,ProgramBench 改按「测试通过率大于 0」算成功,整理如下(只有并发成功 / 只有串行成功 / 两者都成功 / 都没成功):
| 基准 | Codex | Claude Code | Kimi Code |
|---|---|---|---|
| SWE-bench Verified | 9 / 9 / 62 / 20 | 5 / 29 / 54 / 12 | 4 / 22 / 55 / 19 |
| NL2Repo | 7 / 1 / 8 / 10 | 3 / 1 / 14 / 8 | 1 / 4 / 11 / 10 |
| ProgramBench | 5 / 2 / 39 / 4 | 3 / 3 / 0 / 44 | 5 / 1 / 0 / 44 |
| RepoZero | 4 / 3 / 57 / 86 | 0 / 24 / 40 / 86 | 6 / 4 / 52 / 88 |
| LoopsBench | 1 / 0 / 6 / 21 | 4 / 0 / 2 / 22 | 2 / 2 / 5 / 19 |
几乎每个 agent、每个基准都有只在并发下才解决的任务。最明显的是 Claude Code 在 LoopsBench 上,4 个任务只有并发做出来,没有一个只在串行下做出来。短任务上,Claude Code 总分低了很多,仍有 5 个任务只在并发下解决;Codex 两种模式总分一样,各自都有 9 个对方没做出来的任务。
代价:token、调用和时间
同一张表 2 里的资源数据(前为并发,后为串行):
| 基准 | 指标 | Codex | Claude Code | Kimi Code |
|---|---|---|---|---|
| SWE-bench Verified | token(百万) | 3.37 / 1.34 | 2.14 / 1.02 | 1.01 / 0.98 |
| 时间(分钟) | 5.1 / 4.5 | 27.8 / 17.5 | 12.3 / 11.5 | |
| RepoZero | token(百万) | 2.47 / 0.89 | 4.03 / 2.42 | 1.33 / 0.82 |
| 时间(分钟) | 7.2 / 6.3 | 39.3 / 29.0 | 19.3 / 17.1 | |
| NL2Repo | token(百万) | 8.00 / 2.87 | 8.55 / 6.53 | 2.70 / 2.21 |
| 时间(分钟) | 9.9 / 9.4 | 39.0 / 34.3 | 24.4 / 18.4 | |
| ProgramBench | token(百万) | 27.05 / 9.19 | 6.02 / 6.18 | 11.64 / 6.05 |
| 时间(分钟) | 24.9 / 23.4 | 38.9 / 38.7 | 39.9 / 40.1 | |
| LoopsBench | token(百万) | 51.65 / 11.45 | 21.73 / 15.52 | 41.49 / 11.29 |
| 时间(分钟) | 18.8 / 17.7 | 91.5 / 74.8 | 55.8 / 52.7 |
shell 调用次数(主 agent 加所有子 agent)在每个组合上都增加了,常常是好几倍,Claude Code 在 LoopsBench 上从 107.4 次涨到 791.6 次。
按 agent 汇总,token 是串行的 1.41 到 3.31 倍。表里只有 Claude Code 在 ProgramBench 上并发略省一点(6.02 对 6.18 百万)。多花的 token 没有换来相应多的成功:把全部 token 摊到解决的任务上,三个 agent 每解决一个任务花的 token 都变多了。整体略有提升的 Codex,并发下每解决一个任务要 2,412 万 token,串行只要 769 万。
按平均耗时算,并行没有让任务更快完成。15 个 agent 与基准的组合里有 14 个平均耗时变长,唯一的例外是 Kimi Code 在 ProgramBench 上(39.9 对 40.1 分钟)。Claude Code 做 SWE-bench Verified,并发每题平均 27.8 分钟,串行 17.5 分钟,解决得还更少。也有快的时候:两种模式都解决了的 366 个任务里,并发更快的有 102 个(27.9%),其中 46 个(12.6%)至少快了 20%。
子 agent 开多少、什么时候开
论文图 5 统计了每次运行创建的子 agent 数和同时在跑的峰值。所有运行合起来,易、中、难任务平均创建 6.69、7.53、15.84 个子 agent,峰值平均 3.66、4.61、6.70。LoopsBench 上变化最大,从易到难,每个任务平均创建的子 agent 从 16.25 个涨到 68.18 个;它只占难任务的 14.6%,却贡献了难任务里 62.9% 的子 agent。
三个 agent 的习惯差别很大。Codex 把一部分实现留给主 agent 自己做,只维持一小组子 agent,各任务组的平均峰值在 1.21 到 3.00 之间。难的 LoopsBench 任务上,Claude Code 平均创建 133.69 个子 agent,峰值 25.46,它会在工作流后续阶段不断开新的一组;Kimi Code 创建 67.00 个,峰值却有 37.46,因为它一次发一大批。
作者还检验了任务难度和子 agent 创建数、峰值的关联,并做了多重比较校正。30 组检验里,论文点名的显著结果是创建数上的两组:Claude Code 在 ProgramBench(ρ=0.470,p=0.015),Codex 在 SWE-bench Verified(ρ=0.316,p=0.042)。论文的说法是,这种关联只在部分设置下显著,任务结构和协调机制也会影响派发。作者的解释是,任务变难可能只是某个核心组件更费力,能独立拆出去的子任务并没变多。
时间上,论文把每条轨迹从第一条到最后一条记录归一化成 0 到 100%,图 6 画了各时间点平均有几个子 agent 在跑。
- 什么时候开始派:第一个子 agent 启动时间的中位数,Codex 在轨迹的 4.0%,Claude Code 在 22.1%,Kimi Code 在 26.0%。Codex 每次派一个任务就把控制权还给主 agent,另两家要先写好工作流或拆好批次。
- 有没有真的并行:在每个 agent 的 354 次运行里,创建了子 agent、却从没有两个同时在跑的运行,Codex 占 24.3%,Claude Code 和 Kimi Code 只有 1.7% 和 2.8%。
- 并行持续多久:至少两个子 agent 同时在跑的时间占比,中位数是 Codex 23.9%、Claude Code 52.7%、Kimi Code 15.6%。
- 什么时候结束:最后一个子 agent 结束时间的中位数,Codex 在 83.3%,Claude Code 在 100.0%,Kimi Code 在 93.6%。Codex 的主 agent 最后还留出一段时间自己实现和检查,Claude Code 到评审阶段还会再开子 agent。
28 种失败模式
怎么标的
作者人工标注了全部 1,062 条并发轨迹,每条都对照同一 agent 在同一任务上的串行轨迹,覆盖主 agent、所有子 agent 和产物。先用 50 条轨迹建立编码表,再由三名标注者正式标注,每条由两人独立标。一致性 Cohen’s κ 为 0.77,这个系数衡量扣除随机巧合后两人的一致程度,越接近 1 越一致。
最后得到 4 个大类、13 个子类、28 种失败模式。1,062 条轨迹里,650 条至少出现一种失败模式,共 804 个实例,一条轨迹可以有多个。每个子类还标了类型:功能性失败指有活没人负责、信息没传到、写入没隔开、进度看不到,或者没验收;性能性失败指在给定执行预算下协调低效。
论文表 3 整理成中文如下(括号里是实例数和占 804 个实例的比例):
| 大类 | 子类 | 失败模式 | 类型 |
|---|---|---|---|
| 任务编排 229(28.5%) | 缺少负责人 16(2.0%) | 实现无人负责 14(1.7%);组装无人负责 2(0.2%) | 功能性 |
| 伪并发 47(5.8%) | 等预检完才开工 7(0.9%);调查串行进行 40(5.0%) | 性能性 | |
| 负载不均 166(20.6%) | 关键路径分不到资源 3(0.4%);子 agent 开太多耗光预算 154(19.2%);单个子 agent 任务过大 9(1.1%) | 性能性 | |
| 执行管理 233(29.0%) | 启动、汇合或取结果的时机不对 166(20.6%) | 子 agent 过早被终止 128(15.9%);收尾太晚 5(0.6%);验证后才合入改动 7(0.9%);实现结果没汇合 9(1.1%);验证者结果没回来 17(2.1%) | 功能性 |
| 失败传导 42(5.2%) | 失败无人接手 42(5.2%) | 功能性 | |
| 主 agent 不主动监控 25(3.1%) | 完成的结果没被用上 13(1.6%);盲等超时 12(1.5%) | 性能性 | |
| 全局上下文 75(9.3%) | 任务要求缺失 23(2.9%) | 子 agent 的任务说明不完整 23(2.9%) | 功能性 |
| 接口约定缺失 5(0.6%) | 子 agent 之间没有约定接口 5(0.6%) | 功能性 | |
| 交接过载 4(0.5%) | 交接中丢信息 1(0.1%);一次交接内容过多 3(0.4%) | 功能性 | |
| 宣布完成缺乏依据 18(2.2%) | 未验证就宣布整体完成 18(2.2%) | 功能性 | |
| 原样重试 25(3.1%) | 重试不带上次进展 25(3.1%) | 性能性 | |
| 共享状态与合并 267(33.2%) | 并发写入 213(26.5%) | 跨文件职责范围冲突 5(0.6%);同文件冲突 42(5.2%);源码被覆盖 14(1.7%);交付物被覆盖 120(14.9%);最终文件树被覆盖 6(0.7%);未隔离的工作区写入 26(3.2%) | 功能性 |
| 共享环境污染 54(6.7%) | 产物泄漏到共享环境 54(6.7%) | 功能性 |
单看失败模式,最多的三种是子 agent 开太多耗光预算(154)、子 agent 过早被终止(128)、交付物被覆盖(120)。
任务编排
这一类是主 agent 没把活在自己和子 agent 之间分好,占 28.5%。
缺少负责人:有的活谁都没分到。Kimi Code 重建 NL2Repo 里的 verifiers 仓库时,派 5 个子 agent 分别做解析器与评分规则、工具脚本、文档、示例环境和模拟客户端,核心的 verifiers/envs 模块却没人负责,最终提交的包一个官方测试都没过。
伪并发:子 agent 并行跑着,决定任务能否完成的那部分工作还是串行的。Kimi Code 重建 ProgramBench 里的日志高亮工具 tailspin 时,17 个子 agent 同时调查程序的不同行为,没有一个负责实现。主 agent 等所有报告回来才自己开始写,结果运行在实现规划阶段就结束了,785 个测试一个没过。
负载不均:花在部分并行活动上的精力太多,关键工作没时间做。它占全部实例的 20.6%,在 Claude Code 的失败实例里占 39.8%。同样是 tailspin,Claude Code 的主 agent 一边搭 Rust 框架,一边让工作流派子 agent 调查十个行为领域,还开了评审子 agent,调查和反复派发一直持续到截止,主 agent 手里只剩一个编译不过的 crate。
执行管理
这一类是派完活之后没管好,占 29.0%。
时机不对:子 agent 的工作开始、结束或被采纳的时机不对,该有的结果没赶上最终提交。seqtk 任务属于这一类,下图是论文画的派发过程。
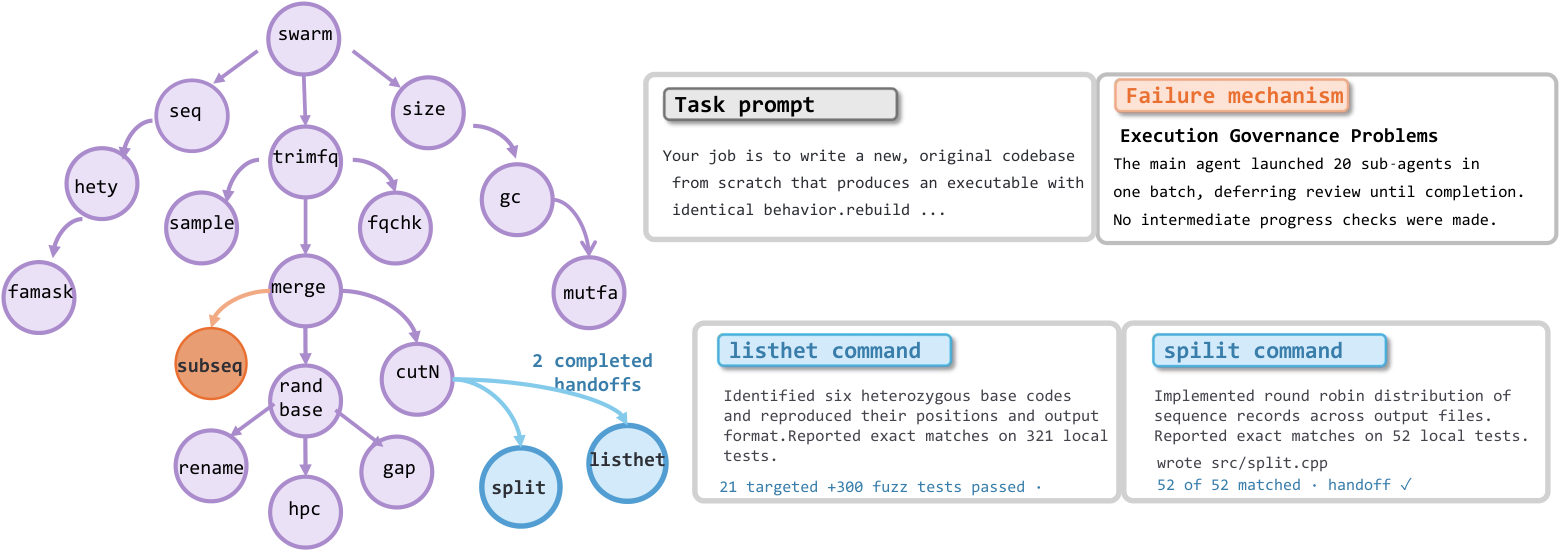
seqtk 是处理生物序列的命令行工具,任务要求参照它的可执行文件和文档重写一个行为一致的程序,预算 40 分钟。Kimi Code 的主 agent 先写好序列读取器、命令分发器和构建脚本这些公共代码,第 17.5 分钟把 22 个子命令一次性分给 20 个子 agent,11 秒内全部启动。随后主 agent 等整批返回,它按两小时的子 agent 超时来等,比整个任务预算还长。负责 listhet 和 split 的子 agent 在第 22.3 和 26.7 分钟就报告完成(图右两个框)。
主 agent 却再没调用过工具,计划中的集成和最终测试一直没做。截止时其余 18 个子 agent 被中止。负责 seq 的子 agent 没写出实现,官方测试调用 seq -Q 64 只得到「unrecognized command」,最后 440 个测试过了 92 个。论文的评价是,派活本身合理,时机和预算对不上。
失败传导:子 agent 没完成,主 agent 既不重试也不接手。Claude Code 做 canonicaljson 迁移时,一个负责搜索参数解析反例的子 agent 因限流被中断,主 agent 直到超时都没重启它,也没接手这项验证,最终 148 个官方测试过了 147 个。
主 agent 不主动监控:主 agent 没有重新评估进度。Claude Code 做 RepoZero 的 hopscotch-map 迁移时,主 agent 已经把 Rust 版本构建好、检查过、放进输出目录,临近截止却开始阻塞等待一个没完成的子 agent,一等十分钟,运行在给出最终回复前被终止。这个产物 39 个官方测试全能过。
全局上下文
这一类是在各自上下文里干活的 agent 缺了把工作接起来所需的信息,占 9.3%。
任务要求缺失:Kimi Code 重建 icecream 时,任务要求通过 from icecream import * 导出包的元数据,负责打包的子 agent 没被告知,交回的 __init__.py 原封不动。产物虽然过了全部测试,但看不到这条要求被处理过的证据。
接口约定缺失:Kimi Code 重建 python-fsutil 时,写实现和写测试的子 agent 分到各自的文件,没有一份完整的共享 API 约定。负责权限的子 agent 返回整数,写测试的子 agent 期望的是 “755” 这样的字符串,其他测试还假设了不同的函数签名。第一次集成测试报了 9 个失败,主 agent 只能回头逐个对齐。
交接过载:Claude Code 做 base58 迁移时,工作流把每个探测最多 60 条发现汇总成一份 8 万字符的实现说明,接手的子 agent 没去实现,又把环境、源码和报错重新调查一遍,产出文件前就被中断。
宣布完成缺乏依据:Kimi Code 做 RepoZero 的 bidict 迁移时,4 个子 agent 分别实现不同模块。集成后主 agent 只看了标准输出和退出码,没看标准错误输出,尽管它知道异常输出被简化过、参数解析也有偏差,还是宣布任务完成。
原样重试:Claude Code 做 Clipper 迁移时,卡住的设计任务被用同一份说明反复重派,接替的子 agent 拿不到之前的发现,只能重读源码、重跑探测。四次之后到了截止时间,手里只有一个 Cargo.toml,必需的 Rust 入口文件都没有。
共享状态与合并
这是最大的一类,占 33.2%。多个 agent 在没有协调的情况下读写同一批文件、产物或环境,论文拿传统并发程序里的数据竞争来类比。
并发写入占全部实例的 26.5%,在 Codex 的失败实例里占 62.9%。Codex 做 Clipper 迁移时,主 agent 已经写好并构建了 test5.rs,后来一个子 agent 在共享输出目录里换了一套模块结构,把 test5.rs 和 Cargo.toml 都替换了。产物最后通过了官方测试,但主 agent 之前对产物的认识作废,只能多做一轮计划外的集成。
共享环境污染:Claude Code 重建 clog-cli 时,两个子 agent 各自删掉再重建 /tmp/t1 来放测试数据。Markdown 子 agent 刚建好自己的数据,JSON 子 agent 就把这个路径换掉了,Markdown 子 agent 浑然不知,继续拿错的数据干活。另一次,一个子 agent 替换了系统共享的 Git 可执行文件,同一次运行里后面所有调用 Git 的探测都用上了被改过的版本。
Claude Code 和 Codex 失败的重心不一样:Claude Code 最常见的是负载不均,Codex 最常见的是并发写入。我的推测是,Claude Code 开的子 agent 最多、并行最久,Codex 的主 agent 自己也写代码、容易和子 agent 写到同一批文件,论文没有直接这样归因。
并发什么时候有用
作者另外挑了 131 对轨迹,条件是同一个 agent 在同一任务上,并发版测试通过率更高、或者完全解决了串行没解决的任务、或者在测试通过率不降的前提下至少快 60 秒且快 20%。对比两条轨迹,作者总结出三种反复出现的情况。
第一种是互补分工。Kimi Code 重建 NL2Repo 的 justext 时,主 agent 自己实现核心的正文提取算法,8 个子 agent 负责交付文件和检查,主 agent 在最终验证前整合了全部 8 份结果。两种模式都通过了全部测试,并发把用时从约 734 秒缩到约 468 秒。
第二种是并行尝试再挑选。Codex 重建 ProgramBench 的 Halite 时,主 agent 和一个子 agent 各做了一版这个黑盒游戏环境,主 agent 把子 agent 的地图行为和自己更完善的协议处理拼在一起,391 个测试过了 292 个;串行模式编译失败,0/391。NL2Repo 的 unidecode 任务里,子 agent 分别按 1.3.8 和 1.4.0 两个版本实现,主 agent 比较后采用 1.4.0 的映射表,通过的测试比串行多。
第三种是独立验证。Codex 做 LoopsBench 的安全实验套件任务时,主 agent 在实现整套实验,一个负责密码学的子 agent 发现 ECDSA 随机数重用攻击要用到 P-256 曲线的阶,主 agent 据此把恢复算法改成通用版本,并发产物通过全部检查,串行失败。NL2Repo 的 trimming 任务里,一个嵌套子 agent 探测上游实现,找出了 CSV 表头的正确命名规则,串行版做不到全部通过。
三种情况的共同点是,主 agent 把并行的工作用上了:整合组件、挑出更好的候选,或者采纳纠错证据。论文给实践者的建议也对应这三种情况:任务能清楚拆成独立的组件,同一个问题适合并行做几种尝试,或者可以让独立的子 agent 去验证主实现,这时再考虑开并发;同时要把可能的收益和多出来的 token、工具调用、时间放在一起比。
启发
论文建议按需开启,并列了三种值得开的情况;下面几条是在此基础上的引申。
- 修 bug、改小功能这类短任务,先别开并发。SWE-bench Verified 上 Claude Code 掉了 24 个点、Kimi Code 掉了 18 个点,Codex 持平,多花的 token 和时间都由用户买单。
- 开之前先对照上面三种情况判断任务属于哪一种;都不属于,就让主 agent 串行做。
- 给每个子 agent 划好能写的范围。光交付物被覆盖就有 120 次。可以要求子 agent 只写自己的目录,最终交付目录只由主 agent 写;临时文件路径带上子 agent 的名字,也别让子 agent 动系统级工具。代价是主 agent 要多做一轮合并。
- 把时间预算告诉主 agent,要求它分批派、中途查进度,并给集成和最终测试留出时间。seqtk 的主 agent 按比任务预算还长的超时来等,一批发完就干等。
- 先定接口再分活。让主 agent 先写出共享接口或类型定义,python-fsutil 那 9 个集成失败出在没有共享 API 约定,返回值类型和函数签名都没对上。
- 在提示里写明:子 agent 失败时主 agent 要接手或重派,重派时附上已有发现和更窄的下一步。
- 宣布完成之前,主 agent 自己按任务说明逐条验收,标准错误输出也要看;产物已经验收过,就别再为没做完的子 agent 阻塞等待。
局限
- 每种配置只跑了一次。agent 执行有随机性,作者给的依据是 Codex 在 LoopsBench 上的串行结果和 LoopsBench 原论文报告的接近,原论文多次尝试的趋势也一致。
- 部分基准样本很小。LoopsBench 只有 28 个任务,Claude Code 从 7.1% 到 21.4%,换成任务数是 2 个到 6 个;NL2Repo 只有 26 个。
- 结论限定在三套 agent 与模型组合和五个基准上,用的是默认并发设置。换模型、或者用户自己写好分工说明,结果可能不同。
- 失败分类靠人工标注,κ = 0.77 说明一致性不错,但判断仍有主观成分;三种有用情况来自 131 对挑选出来的轨迹,论文没有统计每种情况出现的频率。
- 论文没有把动态并发和固定流程的多 agent 系统放在一起比,只比了开和关。
写在最后
论文最后给研究者列的方向里,有一条是运行时的监控和干预:发现停住或失败的子 agent,收回没做完的工作,再决定什么时候收结果、什么时候结束运行。前面 seqtk 和 hopscotch-map 两个例子,都属于执行管理这一类失败。